O que o Titanic ensina sobre dados (e sobre modelos que parecem melhores do que são)
2026-10-09
Quem começa em ciência de dados quase sempre passa pelo Titanic. Abre o arquivo, treina um algoritmo, obtém uns 80% de acerto e segue em frente. Eu preparei um material para a pergunta que fica no ar depois disso: o que esses 80% significam, e o que eles não dizem?
O resultado é um conjunto de três peças abertas, em português, para aula e estudo individual: uma página com o código e os resultados comentados, um notebook Python que reproduz tudo e um artigo que liga cada passo à teoria. Os links estão no fim do texto; antes, vale contar o que os dados mostram.
O desafio do Kaggle
O Titanic: Machine Learning from Disaster é a competição de entrada do Kaggle, a plataforma de desafios de ciência de dados. Cada participante recebe 891 passageiros com o desfecho conhecido (sobreviveu ou não) e deve prever o desfecho de outros 418. A base é pequena o bastante para ser lida linha a linha e, ao mesmo tempo, traz quase todos os problemas de um projeto real: dados ausentes (a idade falta em 20% dos casos e a cabine em 77%), texto no nome e no bilhete, variáveis numéricas e categóricas misturadas e relações que só aparecem quando se cruzam duas variáveis.
Quatro coisas que os dados mostram
1. O sexo pesou mais que tudo. Das 314 mulheres do arquivo, 74,2% sobreviveram; dos 577 homens, 18,9%. A razão de chances bruta é 12,4 (intervalo de confiança de 95%: 8,9 a 17,1).
2. A classe mudou o tamanho desse efeito. Entre as mulheres, sobreviveram 97% na 1ª classe, 92% na 2ª e 50% na 3ª. Entre os homens, 37%, 16% e 14%. O teste de interação entre sexo e classe tem χ²(2) = 32,7 (p < 0,001): a vantagem de ser mulher não foi a mesma em todos os convés.
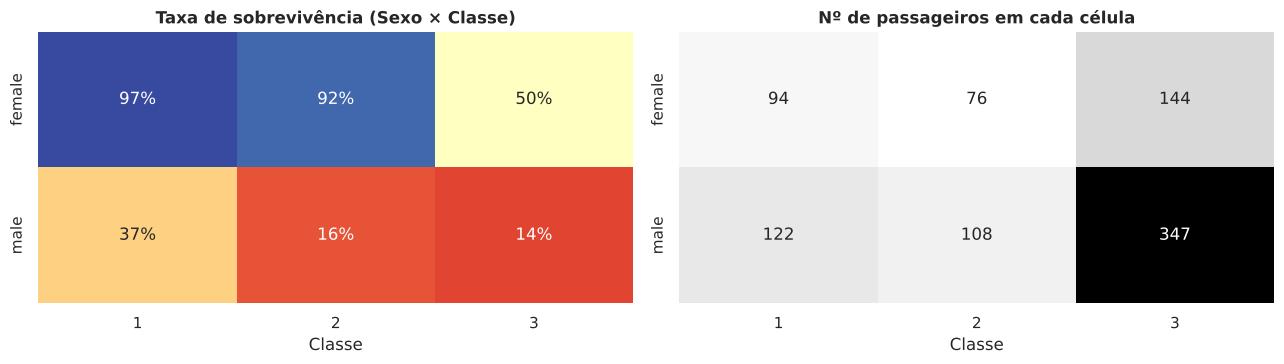
Taxa de sobrevivência por sexo e classe (esquerda) e número de passageiros por célula (direita).
3. O porto de embarque era, em boa parte, a classe disfarçada. Quem embarcou em Cherbourg sobreviveu mais que quem embarcou em Southampton (razão de chances 2,44). Mas 51% dos passageiros de Cherbourg viajavam na 1ª classe, contra 20% em Southampton. Ao controlar classe e sexo, a razão cai para 1,81; no modelo completo, para 1,36 (p = 0,21). A associação bruta enganava sobre a causa, e esse é um bom exemplo de confusão para a sala de aula.
4. Modelos sofisticados quase não superam uma regra de uma linha. Em validação cruzada, cinco classificadores (regressão logística, KNN, SVM, floresta aleatória e gradient boosting) ficaram entre 81,1% e 83,2% de acurácia. A regra "mulher sobrevive, homem morre" acerta 78,7% do arquivo. No conjunto de teste, com 179 passageiros, a diferença entre o modelo escolhido e essa regra não foi estatisticamente distinguível (McNemar exato, p = 0,44). O recado é medir sempre contra uma linha de base e informar a incerteza: com um teste tão pequeno, 1 acerto a mais muda a acurácia em 0,56 ponto percentual.
O que há no repositório
Tudo está em um repositório aberto, com licença MIT para o código e CC BY 4.0 para textos e figuras:
- Página de aula: pauloccoimbra.github.io/titanic-eda-ml-aula. Texto, código com botão "copiar" e resultados comentados, com um modo de apresentação para usar em sala.
- Notebook: Titanic_Analise_Completa.ipynb, que também abre no Google Colab sem instalar nada.
- Artigo didático: artigo.pdf. Liga cada etapa à teoria: intervalo de Wilson, mecanismos de dados ausentes, qui-quadrado e V de Cramér, regressão logística e razão de verossimilhança, viés e variância, validação cruzada, vazamento de dados, calibração e teste de McNemar. Termina com perguntas para seminário.
- Repositório completo: github.com/pauloccoimbra/titanic-eda-ml-aula.
Como usar
Na aula, a página pode ser apresentada de cima para baixo. Depois, o aluno copia as caixas de código na ordem para um notebook vazio (ou usa o botão "Copiar todo o código") e reproduz os mesmos resultados, já que a semente aleatória é fixa. A página traz ainda seis exercícios, como comparar estratégias de imputação da idade ou provocar um vazamento de dados de propósito para ver o que acontece.
Limites
São 891 passageiros de um navio com cerca de 2.200 pessoas, e os números descrevem associações, não causas. A ausência de idade e de cabine tem relação com a classe, e a imputação por título e classe reduz a variância da idade (o desvio-padrão cai de 14,5 para 13,5). Os modelos preditivos esbarram num teto de acurácia perto de 83%, e o que falta explicar (posição no navio, acesso aos botes, decisões individuais) não está no arquivo.
Se você usar o material em aula, vou gostar de saber como foi. Sugestões e correções entram pelas issues do repositório.
Como citar: COIMBRA, Paulo C. Titanic: da análise exploratória à predição de sobrevivência: material didático (página de aula, notebook e artigo). Juiz de Fora: UFJF, 2026. Disponível em: https://github.com/pauloccoimbra/titanic-eda-ml-aula.
Material elaborado com assistência de IA (Claude, da Anthropic) e revisado pelo autor.

